DEEP Robotics представила пять научных достижений в области воплощённого ИИ
Слушать
Нажмите «Слушать», чтобы озвучить текст.
БОСТОН, 24 октября 2026 года (GLOBE NEWSWIRE) — DEEP Robotics представила пять научных достижений, поддерживающих разработку DEEPRobotics-Brain — её архитектуры воплощённого интеллекта (embodied intelligence) для работы роботов в реальном мире. Исследования охватывают физическое предсказание, навигацию и манипуляции, оптимизацию политик, предсказательную память и оценку на основе данных, и все они решают общую задачу: помочь роботам надёжно работать в меняющейся среде.
Пять направлений исследований включают модель мира DR-WM-1.0, фундаментальную модель воплощённого ИИ DR-VLA-2.0, фреймворк оптимизации политик DR-APO, воплощённого агента DR-Agent и платформу данных и оценки DR-Benchmark. Вместе они исследуют, как роботы могут предугадывать результаты действий, переводить инструкции в движение, улучшать обученные политики, корректировать устаревшие пространственные представления и измерять прогресс с использованием данных реального мира.
Пять достижений решают взаимосвязанные задачи в рамках этой архитектуры. Исследования выполнены в сотрудничестве с учёными Массачусетского технологического института, Калифорнийского университета в Сан-Диего, Университета Иллинойса в Урбана-Шампейн, Университета Цинхуа, Чжэцзянского университета, Гонконгского университета науки и технологий и Пекинского технологического института. Вместе эти работы связывают физическое предсказание, навигацию и манипуляции, обучение политик, динамическую память и данные реального мира.
Исследования поддерживают более широкую цель DEEP Robotics — создавать роботов, способных реагировать на человеческие инструкции и практические условия эксплуатации, с оценкой возможностей через симуляцию, эксперименты на реальных роботах и общие тесты.
DR-WM-1.0 придаёт моделям мира физическую основу
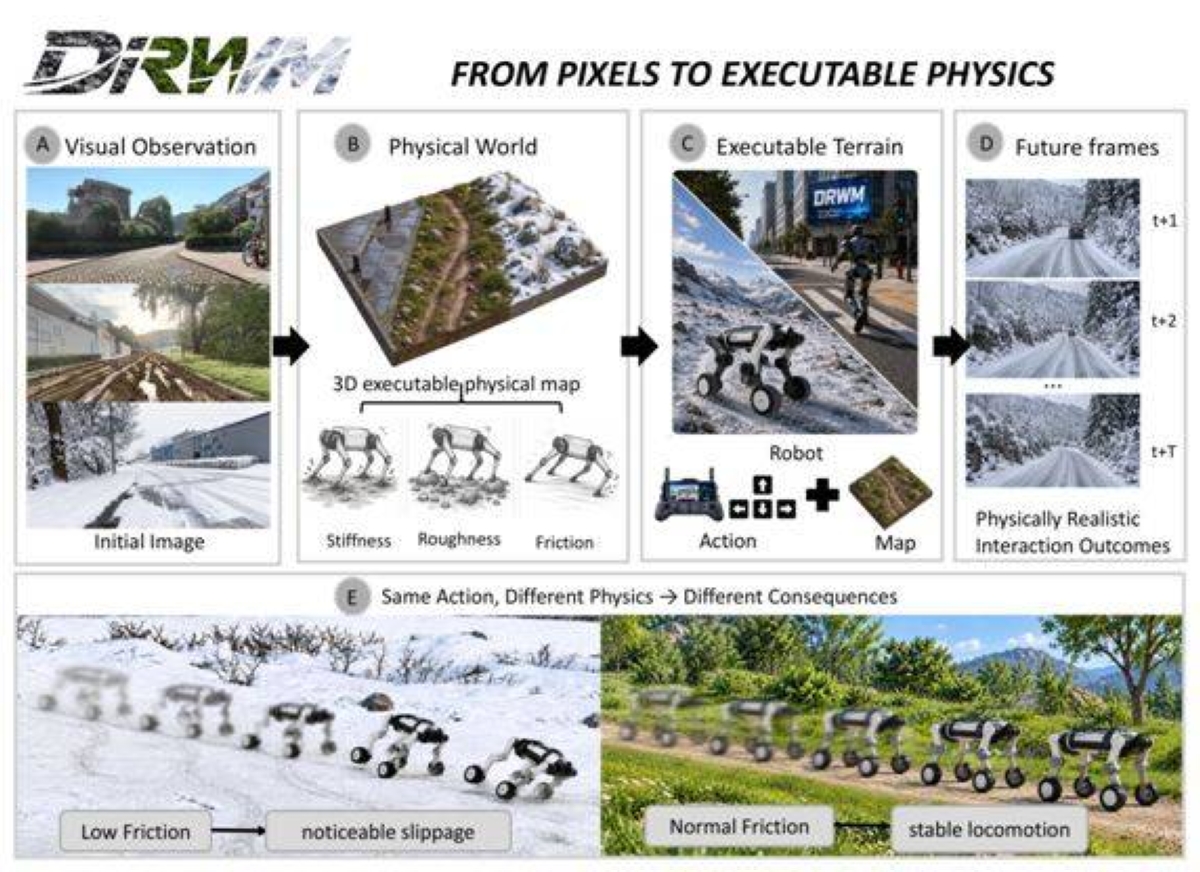
Модели мира дают способ оценивать действия до того, как робот их выполнит. Обычное обучение роботов опирается на многократные пробы и ошибки в реальном мире, что дорого и долго. Видеогенеративные модели мира могут симулировать визуально насыщенные среды, но визуальная правдоподобность сама по себе не доказывает, что предсказанное действие физически выполнимо. Убедительное видео того, как робот переходит снег, например, может не отражать скольжение из-за низкого трения.
Разработанный совместно с исследователями из Чжэцзянского университета, Пекинского технологического института, Университета Цинхуа, MIT и Университета Иллинойса в Урбана-Шампейн, DR-WM-1.0 устраняет этот разрыв, включая динамику контакта робота с рельефом в предсказание последствий действий. Соответствующее исследование DR-WM объединяет реконструированную геометрию сцены с плотными физическими априорными данными о трении, шероховатости и жёсткости, откалиброванными по реальным данным «действие — отклик».
Исследование опирается на 2,58 млн пар «изображение — маска» и более 100 тыс. реальных видеоклипов с роботами. Архитектура с двумя ControlNet обусловливает видеогенерацию геометрией сцены и движением камеры, полученным из симулированного перемещения робота. При авторегрессионных прогонах состояния робота и контроллера переносятся вперёд, сохраняя непрерывность с базовым контуром управления.
Это даёт роботу своего рода физическую репетицию: способ оценить, что может произойти на маршруте, и сравнить альтернативные действия. Связывая восприятие, физическое предсказание и принятие решений, DR-WM предлагает проверяемый подход к сокращению разрыва между визуальным реализмом и физически обоснованным предсказанием.
Показательный пример применения — осмотр подстанции после дождя или снега. Прежде чем выбирать между скользкой короткой дорогой и более длинным маршрутом, робот мог бы смоделировать оба варианта, оценить вероятность скольжения, неустойчивого движения или ограниченного продвижения и взвесить эти риски против эффективности пути.
DR-VLA-2.0 связывает человеческий опыт с навигацией и манипуляциями робота
Чтобы роботы работали на улицах, в кампусах и в среде доставки, навигация должна выходить за рамки планирования пути. Им нужно следовать инструкциям, обходить препятствия, предугадывать изменения и двигаться так, чтобы это было совместимо с человеческой активностью.
Сбор демонстраций роботов через телеуправление дорог и плохо масштабируется на разнообразные среды и взаимодействия. Эгоцентричные веб-видео людей дают обширные примеры обхода препятствий, уступания дороги и выбора маршрута. Однако различия в точке обзора камеры, характеристиках изображения и движении не позволяют напрямую перенести их на роботов, а в таких видео нет исполняемых меток действий робота.
Совместно с исследователями из MIT, Университета Иллинойса в Урбана-Шампейн, Университета Цинхуа и Чжэцзянского университета DEEP Robotics исследует конвейер обучения, который сочетает предварительное обучение без действий на человеческом видео с адаптацией на демонстрациях робота. В соответствующем исследовании DR-VLA представлен EgoLynx, включающий 10 000 часов отобранного эгоцентричного веб-видео и 2000 клипов навигации робота, записанных через телеуправление.
Центральный механизм — доменно-инвариантное представление сцены (domain-invariant scene representation, DISR). Оно объединяет семантическую, пространственную и реляционную информацию, позволяя модели сосредоточиться на том, что присутствует, где оно находится и как элементы сцены связаны друг с другом. Это структурное представление служит интерфейсом для переноса навигационных знаний между наблюдениями человека и робота.
Фреймворк Mixture-of-Transformers объединяет визуально-языковое понимание, латентное моделирование мира и эксперта по действиям на основе flow-matching. Человеческое видео даёт supervision для понимания сцены и предсказания, демонстрации робота — для действий, необходимых для генерации исполняемых траекторий. Подход призван поддерживать социально приемлемое поведение: ожидание, обход препятствий и уступание дороги пешеходам.
На отложенной тестовой выборке EgoLynx-Robot DR-VLA улучшает показатель навигации четвероногого робота (Quadruped Navigation Score, QNS) примерно на 5% и снижает ошибку конечного курса в разомкнутом контуре на 14,6% — по каждому из показателей относительно лучшего конкурирующего результата. QNS объединяет безопасность, следование инструкциям, комфорт и продвижение. Эти результаты указывают на более естественную навигацию роботов в общих пространствах, включая доставку «последней мили» в жилых районах и кампусах.
Манипуляции дают смежную задачу: перевод языка в надёжно управляемое движение. В существующих моделях «зрение-язык-действие» (vision-language-action, VLA) сильные визуальные априорные данные могут перекрывать языковые инструкции. Изменение команды может не перенаправить руку, а задачи с активным контактом, такие как вставка и протирание, требуют, чтобы движение подстраивалось под обратную связь по усилию.
DEEP Robotics и её научные партнёры решают эту проблему с помощью Atomic Motion Coordinate (AMC) — фреймворка для управляемых языком и чувствительных к усилию манипуляций. AMC определяет 13 интерпретируемых «атомов движения» для каждой руки: положительные и отрицательные сдвиги по трём осям, положительные и отрицательные повороты вокруг трёх осей и действие удержания. На начальном этапе обучения визуальные входы исключаются, чтобы согласовать язык с геометрическим движением. Последующие этапы используют визуальный контекст для реализации этих тенденций движения и включают обратную связь по усилию для корректировки генерируемых действий в той же системе координат.
AMC достигает показателей разделения противоположных атомов 92,5% для одноатомных подсказок и 83,1% для двухатомных. В реальных двуручных задачах с ранее не встречавшимися раскладками нормализованный прогресс выполнения задачи достигает 87,8%. Добавление обратной связи по усилию повышает прогресс до 78,5% в задаче «выдвинуть ящик и вставить вилку» и до 75,2% в задаче протирания вазы. Оценки демонстрируют улучшение управляемости языком, обобщения на отложенные конфигурации и адаптации к контакту по сравнению с протестированными базовыми подходами, включая дообученную π0.5 и воспроизведённый подход в стиле LA4VLA.
Возможные применения включают работу с электрическими шкафами, вставку разъёмов и выравнивание компонентов. Результаты поддерживают более интерпретируемое управление манипуляциями.
DR-APO улучшает обучение с подкреплением для разных представлений политик
По мере роста возможностей моделей навигации и манипуляций методы обучения должны поддерживать всё более разнообразные представления действий. Существующие подходы обучения с подкреплением часто рассчитаны на конкретную параметризацию политики, что ограничивает их повторное использование для разных моделей и задач.
Разработанный DEEP Robotics и Чжэцзянским университетом DR-APO (Decoupled-Representation Advantage-Guided Policy Optimization) отделяет улучшение политики от её базового представления. Фреймворк даёт общий принцип оптимизации для гауссовых политик, диффузионных политик и политик на основе flow-matching, поддерживая как обучение непрерывному управлению с нуля, так и дообучение предобученных политик навигации воплощённых агентов.
Его механизм улучшения целей на основе преимущества (advantage) строит улучшенные целевые действия с использованием локальных градиентов преимущества в выполняемых действиях и перевзвешивания по преимуществу. Улучшение политики формулируется как оптимизация целей, не зависящая от параметризации политики. Это позволяет избежать явной оценки правдоподобия политики при обновлении актора и не требует выбора критика среди нескольких кандидатных действий на этапе вывода.
Затем совместимое с представлением прямое приближение действий переносит эти цели на гауссовы, диффузионные политики и политики flow. Это призвано не дать сигналам локального улучшения размыться при многошаговой генерации.
На пяти задачах непрерывного управления MuJoCo-v5 DR-APO показывает лучший результат в девяти из десяти сравнений для диффузионных политик и во всех десяти сравнениях для политик flow, о которых сообщается в исследовании. Он даёт лучшую совокупную производительность только политики для обоих семейств, без выбора критика среди нескольких кандидатов на этапе вывода, оставаясь конкурентоспособным с Soft Actor-Critic (SAC) для гауссовых политик.
При дообучении воплощённой визуальной навигации DR-APO повышает смоделированную долю успеха предобученного NavDP с 70,33% до 89,55%, то есть на 19,22 процентного пункта. В реальных навигационных тестах на колёсно-шагающем роботе DEEP Robotics LYNX M20 успех растёт с 25% до 65% — на 40 процентных пунктов. Эти результаты демонстрируют фреймворк в обучении непрерывному управлению и дообучении навигации, создавая основу для дальнейших исследований других воплощённых политик.
DR-Agent обновляет пространственные представления по мере изменения мира
Надёжная долгосрочная работа требует, чтобы роботы учитывали изменения, происходящие вне их поля зрения. В домах переставляют предметы, гостиничные пространства перестраивают, запасы на складах меняются. Ранее точная память может устареть до того, как робот доберётся до места.
Разработанный с исследователями из Калифорнийского университета в Сан-Диего и Чжэцзянского университета, DR-Agent опирается на EvolvingNav — метод навигации, построенный вокруг предсказательного 4D-представления. Метод решает задачу навигации, когда цели могут перемещаться, пока за ними не наблюдают, в том числе во время пути робота.
EvolvingNav строит привязанное ко времени представление из датированных историй 3D-объектов. Фильтр «предсказание — наблюдение — перепланирование», управляемый событиями, оценивает, где цель, вероятно, будет в ожидаемое время осмотра, включает новые визуальные свидетельства и пересматривает план робота. Это позволяет обновлять память и представления о местоположении по мере изменения среды.
Сопутствующий бенчмарк EvoWorld-Bench основан на следах человеческой активности и включает 54 симулированные сцены, 803 680 экземпляров задач и около 239 000 динамических изменений состояния. Эксперименты показывают улучшение успешности навигации и эффективности поиска по сравнению с оценёнными базовыми подходами, особенно заметное там, где можно выучить временные закономерности. Оценки на FindingDory и GOAT-Bench дополнительно демонстрируют применимость к задачам воплощённой навигации.
Потенциальные применения — от непрерывного автономного обслуживания в домах и общих пространствах до поиска объектов на складах и корректировки маршрутов осмотра на промышленных объектах. Предсказательная, пересматриваемая память помогает решить центральное требование внедрения: сохранять полезное поведение при повторяющихся задачах в меняющейся среде.
DR-Benchmark объединяет оценку на данных реальных роботов
Все эти возможности зависят от данных, связывающих восприятие, намерение и непрерывное движение робота. Существующие наборы данных по роботам и языковой навигации часто дают лишь часть этой информации. Восприятие, навигация, предсказание будущего и реконструкция также часто оцениваются на разных наборах данных и по разным протоколам, что затрудняет согласованное сравнение.
DEEP Robotics разработала DR-Benchmark с исследователями из Университета Иллинойса в Урбана-Шампейн, Гонконгского университета науки и технологий, Чжэцзянского университета, Университета Цинхуа и MIT. В его основе — LynxScenes, крупномасштабный набор данных и бенчмарк реального мира для работы колёсно-шагающих роботов на открытом воздухе.
Собранный с помощью DEEP Robotics LYNX M20, LynxScenes охватывает 833,6 часа и 3294,7 километра работы в реальном мире. Он содержит около 100 тыс. навигационных клипов и 3 млн размеченных кадров, а разметка охватывает 3D-объекты, дорожные структуры, навигационные инструкции и траектории экспертных демонстраций. Аннотации включают 27 категорий объектов, четыре категории дорожных структур и 20 навигационных инструкций, организованных в три уровня.
Бенчмарк сводит четыре взаимодополняющие задачи в единый набор данных реального мира: предсказание траектории по инструкции, восприятие 3D-объектов и дорожных структур в виде сверху (bird’s-eye-view, BEV), предсказание будущей сцены и многовидовую реконструкцию сцены. В исследовании оцениваются 25 репрезентативных моделей, что позволяет более согласованно анализировать навигацию, восприятие, моделирование мира и реконструкцию.
Применения включают изучение того, когда роботам доставки следует продолжать движение, ждать или объезжать в общих пространствах; анализ навигации через узкие проходы и временные препятствия при промышленном осмотре; воспроизведение записанных сценариев для диагностики поведения модели. DR-Benchmark создаёт основу для разработки и сравнения моделей, связывая данные реальной эксплуатации с последующими исследованиями и улучшениями.
Вместе эти научные достижения поддерживают разработку DEEPRobotics-Brain и её базовой архитектуры. Они отвечают взаимодополняющим требованиям робототехники реального мира: физически обоснованное предсказание, навигация и манипуляции по инструкции, улучшение политик, пересматриваемая пространственная память и согласованная оценка на записанном опыте роботов.
DEEP Robotics ведёт эту скоординированную исследовательскую программу для поддержки разработки на разных воплощениях роботов. Связывая эти направления с проверяемыми методами и общими бенчмарками, компания стремится продвигать воплощённый ИИ к надёжным промышленным применениям и устойчивому сотрудничеству человека и робота.
Препринты исследований доступны в разделе исследований Центра разработчиков DEEP Robotics: https://developer.deeprobotics.cn/research/.